2021년 3월 2일 화요일

논문 리뷰 - Universal Sentence Encoder


논문 정보 : 


요약 : 

  • Transformer layer를 이용한 초기 pre-trained 모델
  • Sentence embedding vector를 생성하는 것이 목표
  • Sentence 단위로 transfer learning한 모델이 word 단위로 한 것보다 더 좋다.

모델 - Encoders :

  • 학습 방법 
    • Multi task로 학습했다.
    • Sentence vector는 word 단위 vector를 평균 내어 구했다.
    1. Skip-thought like task
      • 이게 뭔지 몰라서 참조 논문(링크)을 찾아봤다.
      • 간단히 설명하자면, 문장이 3개 있을 때, encoder로 가운데 문장의 vector를 얻고, 두 개의 다른 decoder가 encoder의 vector를 이용해 앞, 뒤 문장의 language modeling을 수행하는 방식이다.
      • Skip-thought 모델 학습 구조


      • Loss는 decoder의 output을 이용하며, 학습이 끝나면 encoder만 사용한다.
      • 원 논문에서는 RNN을 썼으며, 이 논문에서는 transformer를 썼다.
      • 데이터는 Wikipedia, web news를 쓴 것 같다.
    2. Conversational response prediction task
      • 역시 참조 논문(링크)이 필요했다.
      • (대충 봤는데...) siamese network처럼 질문-응답 쌍을 각각 동일한 encoder를 통해 vector representation을 얻은 다음, 맞은 응답이 나올 score를 높이는 방향으로 학습했다.
      • 후속 연구(링크)에 있는 모델 구조


    3. Supervised classification task
      • SNLI로 supervised 학습했다.
      • 후속 연구(링크)에 있는 모델 구조


  • 모델 구조
    1. Transformer layer
    2. Deep Averaging network(DAN)
      • Layer 형태는 feedforward network이다.
      • Input으로 word, bi-gram embedding을 평균내어 사용한다.
    • Input 형태
      • 일단 문장을 PTB style로 tokenize 했다는 것을 보면 word 단위인 것 같다.
      • Vocab에 대한 내용은 없다...
      • System demonstration 논문(링크)에는, oov의 경우, 400,000개의 임베딩으로 hashing한다고 되어 있다.
      • DAN에서는 word embedding과 bi-gram embedding을 같이 썼다고 한다.

Evaluation :

  • 이렇게 사전 학습한 모델로, 다른 여러 task들에 대한 성능을 측정하였다.
  • 학습한 encoder의 output은 각 task에 맞는 layer에 입력으로 사용됐다.
  • Pairwise semantic similarity task의 경우, 두 문장의 벡터 u, v가 있을 때 similarity를 다음과 같이 계산했다.

  • Arccos는 cosine similarity를 삼각부등식을 만족하는 angular distance로 변환하는데, cosine similarity보다 더 좋았다고 한다.
  • 여러 방법으로 실험해 봤으며, 잘 됐다...

  • USE_D는 DAN으로 pre-training한 모델이며, USE_T는 Transformer로 pre-training한 모델이다.
  • Sentence 단위로 transfer learning한 모델이 가장 좋았고 sentence + word로 transfer한 모델이 가장 좋았다.
  • Transformer 모델의 성능이 더 좋았다.


이하 다른 내용들은 생략...

참고 사이트

2021년 1월 12일 화요일

Validation, Test data 차이


Valid Data는 Train Data의 일부로 개발자가 이미 정답을 알고 있다. 그래서 개발자는 val_loss, val_acc같은 값을 알 수 있다. 하지만 Test Data는 개발자가 정답을 알고 있지 않다고 가정한다. 정답이 없는 테스트용 데이터들을 이미 만들어진 모델에 적용시켜 예측한 정답 값을 만들면 개발자는 모르는 Test Data의 정답과 비교하여 최종적인 정확도를 나타낸다. 만약 Test Data에서의 정확도가 낮다면 개발자는 모델을 다시 만들어야겠으나, 모델을 다시 설정할 때 Test Data는 어떤것도 관여하지 않는다. 왜냐하면 답을 모르기 때문이다. 이것은 정말 말 그대로 단지 검증용이다. 여기서 Test Data의 정답을 알아내 모델에 적용하면 그것은 더 이상 Test Data가 아니고 Valid Data가 된다.


출처 : https://welcome-to-dewy-world.tistory.com/7


데이터의 정답을 개발 과정에서 사용하냐 마냐의 차이인가보다.


2020년 12월 21일 월요일

논문 리뷰 - BETTER FINE-TUNING BY REDUCING REPRESENTATIONAL COLLAPSE


논문 정보 : 


요약 :

  • Pretrained 모델의 representation을 훼손하지 않으면서 fine-tuning을 잘 할 수있는 regularization 방법을 제안함
  • 기존 방법들보다 속도가 빠르고 여러 task들에서 성능이 좋음


Learning Robust Representations Through Regularized fine-tuning

  • Pretrained 모델을 특정 task에 맞게 fine-tuning 하면 representation의 generalizability가 훼손됨 : 그 상태로 다른 task에 대해 fine-tuning하면 pre-trained 모델을 fine-tuning할 때보다 성능이 낮아짐
  • 따라서 pre-trained 모델의 변화량을 제한하는 여러 시도가 있었음
  • 수식화 :
    • : 현재 representation density space
    • : 학습 후 representation density space
    • 이 둘의 차이(KL divergence)를 제한

  • p(f)를 알 수 없다… -> reformulation, approximation 등의 시도가 있어왔다.

  • SMART(Jiang et al, 2019)
  • FREELB(Zhu et al, 2019)


  • 이 논문에서 제안하는 방법 : R3F
    • g : fine-tuning 함수, f: pretraining 함수
    • 전체적인 모델(g(f(x))의 변화량을 제한
    • Forward-pass를 두 번 계산해야 한다 : g f(x+z)
      하지만 기존의 기법들은 더 많은 계산이 필요하다.

  • 추가 제약 : R4F


    • 의미 : fine-tuning 함수 g의 변화량을 제한하여 f의 변화량도 제한한다.
  • Lip(g) : 함수 g의 기울기의 상한값
    • 기본 형식 : 

    • 행렬 형식 :

  • 단순히 Lip{g}를 구하면
  • 따라서  하면 Lip{g} <= 1을 만족한다.


Experiments


  • Walltime(가장 성능이 좋은 checkpoint에 도달하는 시간)이 SMART에 비해 짧다.


  • 왼쪽 : Best 성능, 오른쪽 : median 성능


    성능의 편차가 적고, 가장 좋은 성능도 거의 비슷하다(좋을 때도 많이 있다).

  • Summarization task에서는 거의 SOTA를 기록했다.


  • 위 실험은, SST-2 task에 대해 classifier + pretrained model을 fine-tuning 후, Pretrained model을 fix한 상태로 각각의 task에 대해 fine-tuning한 실험이다.

    R3F, R4F(제일 오른쪽 2개)에서 전반적으로 좋은 결과가 나왔다.
    이 말은, R3F, R4F를 사용했을 때,
    pretrained model의 representation을 훼손하지 않고 
    fine-tuning 했다라고 볼 수 있다.


Conclusion

  • 새로운 fine-tuning 방법을 제안했다. : R3F, R4F
  • 이 방법은 pretrained representation의 generalizability를 유지했으며,
    computationally efficient하고,
    실험 결과도 SOTA를 보여주었다.


2020년 12월 15일 화요일

Github package 관련 파일들 역할

 MANIFEST.in


setup.py

  • python setup.py -sdist로 소스 distribution을 만든다.


check-manifest library

  • Version Control System(VCS)에 속한 파일들과 패캐지 파일들을 비교한다. 

2020년 11월 23일 월요일

Multi GPU(RTX 2080 ti)를 이용한 BERT Training 속도 측정

RTX 2080 ti 4개로 학습하면 대략 어느정도 걸릴 지 알아보기 위해 속도를 측정한 결과를 정리한다.

1. NVidia Deep Learning Examples ( horovod ) 


위의 저장소에서 소스를 다운받으면 간편하게 BERT multi gpu 학습을 할 수 있다.
추가적으로 automatic mixed precision도 구현되어 있다.

단점이라면 multi GPU 학습을 위해 tensorflow의 자체 기능 대신 horovod를 썼기 때문에 horovod를 따로 설치해야하는 번거로움이 있다.

--use_xla 옵션을 사용하려면 
export XLA_FLAGS="--xla_gpu_cuda_data_dir=/usr/local/cuda/"
와 같이 XLA_FLAGS 환경 변수를 세팅해줘야 한다.

Mixed precision을 쓰지 않으면 nan loss가 발생한다.

Tensorflow 버전 : 1.14
sequence_length : 512

단위 : examples/sec

Batch_size를 8의 배수로 하면 tensorcore를 쓸 수 있을 텐데 메모리 한계 때문에 쓰지 못한 것이 아쉽다.
속도를 향상시킬 방법에 대해 이슈를 제기했더니 accumulation_step을 늘려보란 답변을 받아서 해봤는데, GPU 4개 batch 7에서 89개로 조금 늘었다.

2. Google-research BERT ( tensorflow.distributed )

실험 소스, 결과 정리 : github repo

구글의 bert 코드에 tensorflow Strategy api를 추가하여 실험했다.


Horovod를 썼을 때와 비교했을 때 크게 차이가 나지는 않았다.

소스 변경을 잘 한 건지 알아보기 위해 V100 4개에서 추가적으로 실험했다.
그 결과 NVIDIA의 실험 결과와 거의 비슷했다.


하지만 생각보다 RTX 2080ti와 V100의 차이는 많이 났다.
일단 메모리가 11G vs 16G라서 V100에서는 batch size를 8까지 늘릴 수 있었고, 최종적으로 거의 2 배 가까운 차이가 났다.

2020년 11월 10일 화요일

Mixed Precision 을 이용한 deep learning


Precision의 종류

  • Precision은 float type 변수의 크기에 따라 달라진다.
  • 출처 : https://www.aitimes.kr/news/articleView.html?idxno=14687
  • 위의 그림처럼 보통 많이 쓰이는 fp32를 single precision이라 하며 mixed precision 방식으로 네트워크를 학습할 때는 half precision인 fp16을 사용한다.
  • 32비트 대신 16비트의 변수를 사용하기 때문에 그만큼 계산이 빨라지고 메모리도 적게 든다.

Mixed Precision의 효과

  • Mixed Precision을 사용하면 모델의 정확도는 별로 차이가 없지만, 학습 속도를 2~4배 정도 빠르게 할 수 있다.
  • Tensorflow로 mixed precision training 했을 때 속도 향상 [1]

  • Mixed precision training 했을 때 loss 변화
    loss가 거의 차이 없이 학습된다(loss scaling이 필요하다) [2]

Mixed Precision 방식의 원리

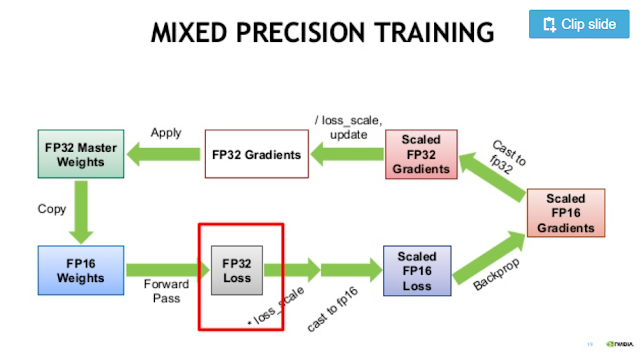
Mixed precision 학습 과정 [3]
  1. FP32 타입의 weight를 fp16 형태로 복사한다.
  2. Input 데이터도 fp16 형태로 바꾼 후, forward pass를 계산한다.
  3. 이 과정에서 norm() 같이 큰 matrix의 reduction 연산이 들어가면 fp16 타입으로는 overflow가 날 수 있으므로 이런 연산은 fp32 타입으로 계산한다. 그 외 matrix multiplication 연산은 fp16으로 계산한다.
  4. Loss 값이 너무 작으면 fp16에서 underflow가 난다. 따라서 loss를 fp32값으로 바꾼 후, loss_scaling(loss 값에 128 같은 값을 곱해서 loss를 크게 만드는 작업)을 해준다.
  5. Loss를 fp16으로 변환 후, gradient를 계산하고, 다시 fp32로 바꾼다.
  6. Underflow를 막기 위해 곱했던 만큼 gradient를 나눠주고 원래의 weight를 update한다.

Tensor Core 란?

  • Tensor Core는 fp16 연산을 더 빠르게 해주는 GPU 내부 모듈을 말한다. [4]
  • Tenor Core는 Volta architecture 이상의 GPU에 탑재되어 있다.
  • Titan V, V100, RTX 20x 시리즈 등이 해당한다. 
  • FP16 type의 연산이 필요한 경우, 특정 조건들(vector, batch size가 8의 배수)을 만족하면 기본적으로 Tensor Core를 활용한 연산을 수행한다.[5]

Tensorflow에서 Mixed precision 쓰기

Tensorflow 1.x

아래의 빨간색 줄을 추가해준다.
opt = tf.train.MomentumOptimizer(learning_rate, momentum) 
opt = tf.train.experimental.enable_mixed_precision_graph_rewrite(opt) 
update_op = opt.minimize(loss)
[7] 참고

Nvidia GPU Cloud(NGC) container를 쓸 경우,
간단하게, export TF_ENABLE_AUTO_MIXED_PRECISION=1
환경 변수를 설정하면 알아서 mixed precision 방식으로 학습을 진행한다.

Tensorflow 2.x

opt = tf.keras.optimizers.SGD()
opt = tf.train.experimental.enable_mixed_precision_graph_rewrite(opt)
train_op = opt.minimize(loss)

를 해주면 된다. [6] 참고
또는 [5]에서처럼 Policy(dtype 결정), loss scaling을 직접 지정하여 학습할 수도 있다.

Pytorch example도 [3]의 26번 슬라이드에서 찾아볼 수 있다.


Tensor Core를 쓰고 있는지 확인해보기

[6]의 31번 슬라이드 참고


참고 자료들

2020년 11월 2일 월요일

논문 리뷰 - What Does BERT Look At? An Analysis of BERT's Attention


논문 정보 :


요약 :

  • BERT의 attention에는 공통적인 패턴이 나타난다.
  • BERT의 attention에는 coreference resolution, dependency parsing과 같은 syntactic한 정보들이 담겨 있다.

Surface-level patterns in attention:

  • 위의 그림처럼 attention이 다음(또는 이전) 토큰들에 걸리는 경우, 특정 토큰([SEP], '.')에 걸리는 경우, 많은 토큰들에 광범위하게 걸리는 패턴들이 나타났다.
  • [SEP], '.'에 attention이 많이 걸리는 이유로, 인풋 데이터에 이 토큰들이 항상 포함되기 때문이 아닐까 추측한다.
  • 또한, 어떤 attention head들에서는 동사-목적어, 소유격 대명사, 전치사 등의 관계에 attention이 크게 걸리는 현상들이 나타나는데, 이 때 관련없는 토큰들은 [SEP]에 attention이 걸리는 현상을 보인다.
  • 그리고, gradient-based measures of feature importance (Sundararajan et al., 2017)를 이용해 attention의 변화가 loss 값에 미치는 영향을 측정해봤을 때, [SEP] 토큰에 걸리는 attention의 영향은 크지 않았다.
  • 그래서 [SEP]에 걸린 attention들은 no-op(역할 없음)을 의미하는 것 같다.
  • 하부 레이어의 어떤 attention head들은 매우 broad한 attention을 갖고 있으며 이 경우 output이 거의 문장 안의 토큰들에 대한 bag-of-vectors가 된다.
  • 마지막 레이어에서 [CLS] 토큰은 매우 broad한 attention 값들을 갖고 있는데, 이 때 [CLS] 토큰을 이용해 next sentence prediction을 수행하는 것을 보면 타당하다고 생각한다.

Probing Individual Attention Heads

  • 각 attention head들을 분석하며, byte-pair 인코딩으로 인해 쪼개져 있는 token들의 attention을 더해 word 단위로 만든다.
  • Attention head들의 dependency syntax 능력을 측정했을 때, 특정 attention head들이 각각 특화된 문법적 관계(명사, 목적어 등)를 찾을 때 좋은 성능을 낸다는 것을 확인했다.
  • 의미적인 관계를 찾는 coreference resolution task에서도, 몇몇 attention head들이 rule-based 모델들과 비슷한 성능을 보여주었다.

Probing Attention Heads Combinations

  • 각 head들이 특화된 관계를 찾는 능력만을 갖고 있기 때문에 모델의 전체적인 능력은 분산되어 있다.
  • 따라서 모든 head들을 이용하여 모든 문법적 관계를 찾는 능력을 아래와 같이 측정해본다.
  • p(i|j) : 단어 i가 단어 j의 syntactic head가 될 확률이며,
    a는 layer k에서 단어 i로부터 단어 j에 걸린 attention이다.
    W, U는 학습되는 파라미터이고,
    v는 각 단어에 대한 GLoVe embedding이다.
    원 안에 +가 있는 기호는 concatenation을 뜻한다.
  • 단어 i->j, 단어 j->i 의 양방향 관계를 고려하며, 단어의 embedding 벡터를 활용하여 attention에 맞는 weight를 학습한다.
  • 실험 결과, 제안한 Attn+GloVe 모델은 상당히 좋은 성능을 보여주었으며, attention head들이 syntax knowledge를 갖고 있다는 것을 알 수 있었다.
  • Structural probe 모델은 BERT의 attention이 아닌, output representation을 이용하여 실험한 결과이다(Hewitt and Manning, 2019). 완전히 동일한 방식의 실험은 아니지만 그래도 이를 통해 attention 자체도 output representation과 비슷한 syntactic 정보가 있다는 것을 알 수 있다.
전체적으로 봤을 때, self-supervised learning으로 학습했어도, syntactic 정보를 학습하기 위해 설계한 모델(recursive neural network)이나 supervised learning으로 학습한 모델처럼 언어의 구조를 학습할 수 있다는 점을 알 수 있다.

Clustering Attention Heads

  • Jensen-Shannon Divergence를 이용하여 각 attention head들의 거리를 측정하고 이를 시각화 했다.
  • Attention의 패턴 별, layer 별로 시각화 해봤을 때, 비슷한 패턴을 보인 attention head, 같은 layer에 있는 attention들이 모여 있는 것을 알 수 있었다.

Conclusion

  • Attention에도 상당한 양의 정보가 담겨 있으며 이를 분석하면 많은 도움이 된다.