2019년 2월 16일 토요일

Bert-Multilingual model을 이용해 KorQuAD 수행해보기 Part 2 제출

지난 번 글에 Pre-trained Multilingual Bert를 KorQuAD에 맞게 fine tuning시키고 평가하는 방법을 올렸다. 이제 이어서, 실제 KorQuAD leaderboard에 내가 훈련시킨 모델을 등록하는 방법에 대해 정리해 보겠다. Codalab을 처음 쓰는 사람이라면 KorQuAD 홈페이지에 링크되어 있는 제출 튜토리얼만 보고는 알아야 할 사항들이 추가적으로 더 있어서 그런 부분까지 포함하는 제출 방법을 써 보았다.

기본적인 참고 url은 KorQuAD 공식 홈페이지에 링크 되어 있는 KorQuAD codalab 페이지이다.


설명대로 CodaLab에 회원가입(Sign up) 한다.
http://codalab.org 에 가보면 아래와 같은 화면이 나온다. Competetions는 현재 codalab에서 진행되고 있는 대회들을 보여준다.


실제 제출을 위해 필요한 작업들은 Worksheets에서 진행된다. 그리고 Worksheets와 Competetions에서 사용되는 계정이 다른 듯하다...(???) 그러니 Competetions은 둘러보기만 하고 Worksheets 페이지에 가서 Sign up 하자.


로그인하면 위와 같은 화면이 보일 것이다. My Home은 기본으로 만들어진 worksheet을 보여주고, My Dashboard는 나의 모든 worksheets, 기타 여러 정보들을 보여준다. 기본 worksheet을 써도 좋고, 새로운 worksheet을 만들어도 상관없다.

---------------------------------------------------------------------------------------------------

Dev set 평가 단계


이제 KorQuAD codalab 페이지의 Dev set 평가 단계를 진행해보겠다. 이 단계는 그리 어렵지 않고 그냥 써 있는대로 하면 된다.
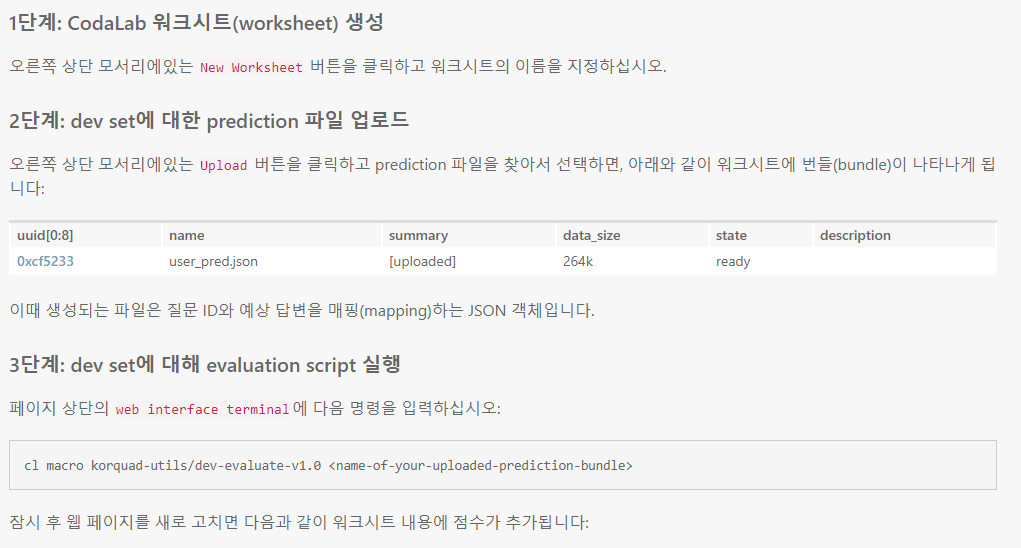


My Home이나 My Dashboard 아무거나 누르고, 우측에 New Worksheet 버튼을 누르면 새로운 worksheet이 만들어진다
새로 만든 worksheet은 아래와 같다.


None은 worksheet의 타이틀로 클릭하여 수정할 수 있다.

2단계에 써져 있는 것처럼 우측의 Upload 버튼을 눌러 predictions.json(test data에 대해 답을 예측한 파일)을 업로드 한다.
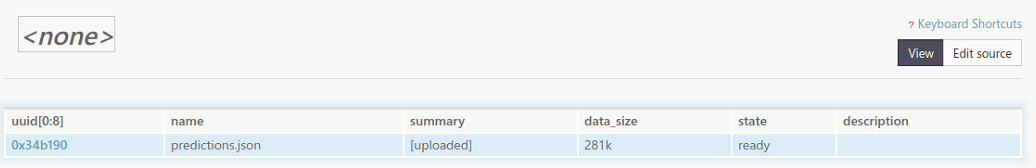

업로드하면 위와 같이 worksheet에 파일이 추가된다.

3단계에 나온 것처럼 화면 위의 web interface에 명령어를 입력하여 업로드한 predictions.json에 대한 평가를 진행한다. 참고로 worksheet에 생성되는 객체(entity, object, instance 등..)을 bundle이라고 부른다.

명령어를 실행하면 아래와 같은 실행 결과에 대한 bundle이 생성된다.


여기서 보이는 점수는 local 환경에서 평가한 점수랑 동일한 점수이다. 실제로 leaderboard에 점수를 등록하기 위해서는 내 컴퓨터에서 dev set에 대해 예측한 predictions.json 파일이 아니라, 훈련시킨 모델을 업로드하고 codalab 상에서 비공개된 test set에 대한 평가를 진행하는 작업이 필요하다.

여기까지 진행하는 데는 사실 이 글을 읽을 필요가 없다. 그냥 KorQuAD codalab 페이지의 Dev set 평가 방법만 보고 하면 된다. 이 글을 쓰게 된 이유는 Test set을 평가하기 위해서는 안내 사항 외에 알아야 할 게 더 있기 때문이다.

---------------------------------------------------------------------------------------------------

Test set 평가 단계


안내 사항에 써 있듯 우리는 "Codalab에서의 파일 업로드 및 명령 실행에 익숙"한 상태가 되어야 한다.


일단, 훈련된 모델의 소스 폴더를 업로드하라고 하는데 웹 페이지 상에 있는 Upload 버튼으로는 폴더 또는 여러 개의 파일을 올리는 것이 불가능하다.

실제로 이 단계를 수행하기 위해서는 Codalab을 사용하기 위한 Command Line Interface가 필요하다. CLI를 설치하기 위해서는 여기에 가서 2. Install the CLI에 나온대로 따라 하면 된다.


이제 cli를 이용해 폴더를 업로드할 수 있다. 위에 링크된 페이지에 3. Uploading files 부분을 참조하면 된다.

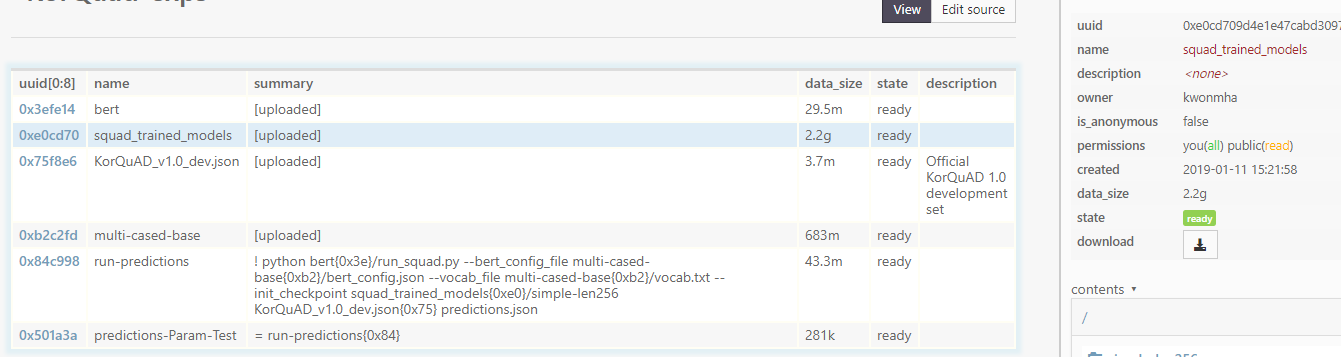
편의를 위해 "cl upload 폴더 -n 이름" 처럼 뒤에 -n 옵션을 붙여서 업로드하면 로컬 폴더가 복잡한 이름으로 되어 있을 경우 짧게 바꿀 수 있다. 그 외에도 파일/폴더를 올린 뒤에 클릭하고(화면에서 파란색처럼 선택된 게 보임) 오른쪽 name을 누르면 bundle의 이름을 수정할 수 있다. 위의 이미지에서 src는 로컬 환경의 폴더를 업로드한 bundle 이름이다.


또한 위의 1단계 안내 사항을 보면 실행 명령이 "python 스크립트파일 input-data-file prediction-json-file" 이렇게 되어야 한다고 명시되어 있다. 이에 맞춰 소스를 수정해주어야 한다.

기본적으로 github에서 다운받은 상태의 소스는 모두 "--option 설정값" 이런 식으로 인자를 주어야 한다. 옵션으로 설정하는 input-data-file, prediction-json-file을 args[1], args[2] 이렇게 인자로 받을 수 있도록 수정해준다.


그리고 config_file, vocab_file, checkpoint_file을 한 bundle 안에 묶어서 upload하는 게 편하다. pre-trained만 된 checkpoint_file은 올리지 않아도 된다. 하지만 로컬에서 한 폴더 안에 있지 않다면 따로따로 upload하며 각각 bundle을 만든 후 위의 이미지에서 run-predictions 번들의 summary에 써 있는 것처럼 bundle 이름과 그 안의 파일을 지정하여 실행할 수도 있다.

위의 이미지를 기준으로 소스 파일들은 bert(run_squad.py), pre trained 모델은 multi-cased-base(vocab, config file), fine-tuned 모델은 squad_trained_models bundle(init_checkpoint)에 각각 저장되어 있다. 따라서 옵션으로 파일을 지정할 때 --vocab_file bundle_name/file_name 이런 식으로 지정하면 된다.


이제 마지막으로 필요한 평가 파일(dev set)을 추가하기 위해 위의 명령어를 web interface 상에서 실행한다.

실제 수행해야 할 명령은 아래와 같다.


이 때 -n bundle_name에서 지정한 이름대로(이미지 상에서 run-prediction) bundle이 생성되고 그 안에 predictions.json 파일이 생성된다. 그리고 이미지 상에서 :KorQuAD_v1.0_dev.json, :src은 번들 이름을 말하는데 꼭 안 써도 되는 것 같기도 하다. 명령어 안에 번들이름/필요파일 이렇게만 써도 되는 것 같다.


또하나 중요한 점은, 이 작업을 gpu로 수행시켜야한다는 점이다. 안 그러면 수행 시간이 엄청나게 길어질 것이다. 위의 명령어는 docker 상에서 수행되며 docker의 타입이 gpu를 지원해주는 버젼이어야 한다.

그래서 명령어 뒤에 추가적으로 --request-docker-image tensorflow/tensorflow:1.12.0-gpu-py3(Tensorflow버전과 python 버전에 맞게), --request-gpus 1 --request-memory 8g(기본 세팅인 2g는 너무 작아 프로세스가 죽을 수 있다. 넉넉하게 세팅한다.)을 넣어서 실행한다.


최종 명령어는 cl run "python 소스번들/run_squad.py --필요옵션들 필요번들/필요파일들 dev.json파일 predictions.json" -n 만들어질번들이름 --request-docker-image 도커이미지이름 --request-gpus 1 --request-memory 8g 이다.


이제 -n으로 지정한 번들이 생길 것이다. 번들을 클릭하여 상태를 보면 실행 중인지, 실행이 끝났는지 알 수 있다.  그리고 실행이 끝나면 번들 안에 predictions.json 파일이 생성된 것을 볼 수 있다.

이제 다음 단계를 수행한다.


위 작업은 run_squad.py를 수행한 번들 안의 predictions.json을 따로 빼서 독립된 번들로 만들고, 그 파일에 대해 평가하는 과정을 설명한다. 두 명령어를 다 실행하면 업로드한 predictions.json을 평가할 때처럼 점수를 표시해주는 번들이 새로 생긴다.

첫번째 명령어에서 run-prediction만 -n으로 지정한 번들 이름으로 변경해주면 된다. {MODEL-NAME}은 원하는 대로 지정한다.

이제 마지막 3단계:제출 부분에 써 있는대로 하면 제출이 완료된다.

끄읕!
---------------------------------------------------------------------------------------------------

처음 제출할 때만 해도 baseline 모델과 naver에서 만든 모델 2개 밖에 없었다. 하지만 내가 제출한 모델의 결과가 leaderboard에 반영되었을 때 다른 2개의 모델이 한꺼번에 같이 업데이트 되어 그 때 당시의 naver 모델보다 더 좋은 결과를 냈지만 3등이 됐다... ㅜㅜ
메일이 저렇게 왔다. ㅋㅋㅋ

어짜피 이후 네이버도 더 좋은 모델을 만들고 카카오도 참전하고... 해서 더 순위는 내려갔지만...

1등 언제 찍어보지 ㅜㅜ

2019년 1월 10일 목요일

Bert-Multilingual model을 이용해 KorQuAD 수행해보기 Part 1 훈련 및 평가

지난 2018년 10월 구글에서 기존 SQuAD 1.1 task에서 human performance를 넘어서는 BERT 모델에 대한 논문을 발표했다. SQuAD는 현재는 SQuAD dataset이 2.0으로 업그레이드( 더 어렵게) 되었고, 구글이 BERT로 SQuAD 2.0에서도 1등을 한 이후(2018. 11/15), 여러 팀들이 BERT에 여러 아이디어를 추가해 구글을 넘어서는 결과를 만들어냈다(아직까지 human performance를 넘지는 못했다). 이처럼 BERT 모델은 현재 NLP 분야에서 기본적으로 응용해야 하는, 꼭 알아야 되는 모델이 되었다.

그리고 지난 12월 LG CNS에서 한국어로 된 SQuAD 1.0과 같은(2.0와 같은 형식은 아니다.) 데이터셋 KorQuAD1.0을 공개했다. https://korquad.github.io/

그래서 BERT 모델과 KorQuAD 데이터셋을 이용해 QA task를 수행하는 과정을 정리해보려고 한다. 그리고 과연 BERT를 한국어에 적용했을 때 성능은 얼마나 좋을 지도 확인할 수 있는 좋은 기회이기도 하다.

모델 준비

*유의 사항
BERT 모델을 train, inference(predict)에 이용하기 위해선 최소한 8G의 gpu 메모리가 필요한 것 같다. 1060 6g 모델에서는 out of memory가 뜨고 codalab의 Tesla m60 8g gpu를 썼을 때는 괜찮았다.

영어 모델을 한국어에 적용하는 과정은 얼핏 생각하기에 어려울 수도 있겠지만 구글이 친절하게(무섭게도) Multilingual BERT 모델을 공개해 놓았다. 이 모델은 100개 이상의 언어에 적용할 수 있다. ㄷㄷㄷ...

https://github.com/google-research/bert
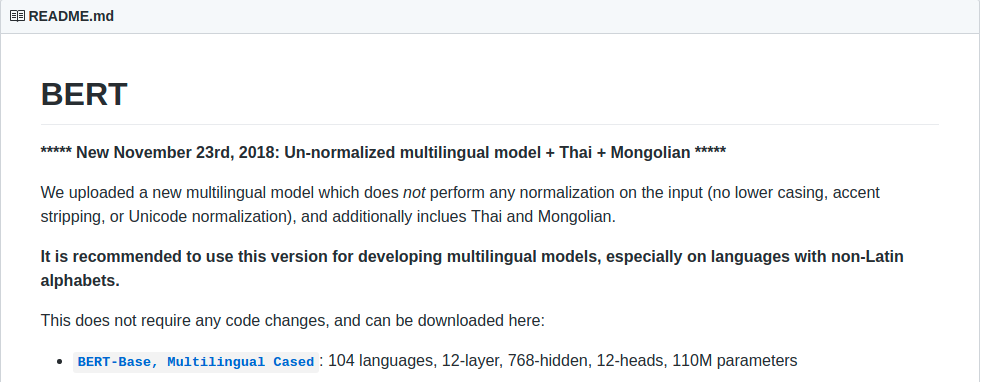
에 가면 Readme 파일 제일 윗부분에 아래 그림처럼 링크가 걸려있다.

파란 글씨 BERT-Base, Multilingual Cased를 누르면 압축파일이 다운받아지고, 압축을 풀면 된다.


데이터셋 다운로드

위에 써 있는대로 https://korquad.github.io/ 에서 데이터셋을 다운받을 수 있다.
train, dev 데이터와 evaluate script까지 다운로드 받는다.

Fine-tuning 

이제 Pre-trained 모델을 KorQuAD task에 맞게 fine-tuning하기 위해 https://github.com/google-research/bert repository를 clone하거나 다운로드 받는다.

이제 준비가 다 끝났다.
argument를 맞춰서 실행해주면 된다.

python run_squad.py
--bert_config_file "pretrained 모델 폴더의 bert_config.json"
--vocab_file "pretrained 모델 폴더의 vocab.txt"
--output_dir "훈련된 모델이 저장될 폴더" (prediction 결과도 이 폴더에 저장된다.)
--do_train (훈련을 하겠다는 옵션)
--train_file "KorQuAD  데이터셋 폴더의 KorQuAD_v1.0_train.json"
--do_predict (predict 하겠다는 옵션)
--predict_file "KorQuAD 데이터셋 폴더의 KorQuAD_v1.0_dev.json"
--do_lower_case=false (현재 다운받은 Cased 모델은 이 옵션을 적용하지 않는다.)
--max_seq_length 적당히
--train_batch_size 적당히
--init_checkpoint "pretrained 모델 폴더"

max_seq_length와 train_batch_size 옵션은 메모리 사용량과 관계가 있다.
아래와 같이 구글에서 12G 메모리 기준으로 max_seq_length와 train_batch_size를 얼마로 해야 좋은지 실험한 결과를 공개했다.
이를 참고하여 쓰는 gpu의 메모리에 맞게 값을 조정하면 되겠다.

그 외 메모리와 관련된 추가적인 사항은 https://github.com/google-research/bert#out-of-memory-issues 를 참고하면 된다.

gpu의 성능에 따라 다르겠지만 훈련에는 대략 2~5시간 정도 소요될 것으로 예상된다.
epoch는 기본으로 3으로 설정되어 있다.

점수 평가하기

훈련이 잘 끝났다면 output_dir에 훈련된 모델 파일과 prediction.json 파일이 생겼을 것이다.
점수를 평가하기 위한 명령을 실행하여 점수를 확인해 본다.

python evaluate-v1.0.py KorQuAD_v1.0_dev.json predictions.json
evaluate-v1.0.py는 KorQuAD 홈페이지에서 받을 수 있으며 3가지 파일의 위치를 잘 지정해서 실행하면 내가 훈련한 모델이 낸 답들을 평가할 수 있다.

꽤 높이 나와서 놀랐다.
내가 한 건 단순 다운로드 & 실행 뿐인데...


이제 내가 훈련한 모델을 KorQuAD leaderboard에 등록할 차례이다.
이 부분에 대한 포스트는 다음에 작성하도록 하겠다.

여기까지 수고 많으셨습니다.

2019년 1월 1일 화요일

20190102 일기

새 해 첫 일기다... ㅜㅜ

--------------------------------------------------------------------------------------------------------------
페이스북인가에서 본 글에서, 우리나라 교육의 문제점을 지적하며 천재가 없다는 얘기를 했다.

그 이유야 여러가지가 있겠지만, 우리 나라 사람들이 사람의 단점을 많이 신경쓰기 때문이 아닌가 생각한다.

모든 것을 다 잘 할 수 없는데, 뭔가 하나를 엄청 잘한다고 하면, 다른 건 잘 못하잖아? 라는 식으로 폄하할 수 있다.

이어서, 이런 식으로 사람을 평가하는 이유로 사촌이 땅을 사면 배가 아프다는 말처럼 시기 질투 때문일 수도 있고, 실패에 대한 두려움도 있기 때문이 아닐까 생각한다.

엄청 잘하는 그 분야에서도 꼭 성공하리란 보장이 없는데, 그걸 실패하면 뭐 할거냐 이런 식으로.

물론 인성이 글러먹으면 안 되겠지.


비슷하지만 약간 다른 문제로, 사람을 사귈 때 장점을 볼 것인가 단점을 볼 것인가가 있다.

물론 인간관계는 사바사, 케바케지만, 장점, 또는 배울 점이 명확한 사람과 지내는 것과 큰 장점이 없지만 또 크게 불편하지도 않은 그런 사람과 교류한다고 했을 때 어느 쪽이 더 편한지.

이때까지 나는 나와 맞지 않는 부분에 좀 더 초점을 맞추며 사람을 봐 왔던 것 같다.

2018년 12월 17일 월요일

논문 설명 - ELMo : Deep contextualized word representations

Deep contextualized word representations (NAACL 2018)
ELMo : Embedding from Language Model


논문 링크 : https://arxiv.org/abs/1802.05365

요약 : 

기존의 Word2Vec, Glove 등에 비해 context 정보를 반영하는 향상된 Pre-training 방법 제시.
여러 층의 Bidirectional LSTM을 이용해 Language Modeling을 하며, 이 때 만들어진 hidden state들을 적절히 조합해 새로운 word representation을 만들어낸다.
새로운 representation을 여러 NLP Task들을 위한 Network의 입력 단에 concatenate(예를 들어 [Word2vec;ELMo]) 하면 여러 NLP Task들의 SOTA를 뛰어넘을 수 있다.


1. 서론

이 논문은 Syntatic, Semantic(문법적, 의미적) 정보를 잘 반영하며, 동음이의어 같은 문맥 정보를 잘 반영하는 word representation을 얻을 수 있는 pre-training 방법을 제시한다. ELMo를 통해 문장 내의 다른 단어들의 정보(context)를 반영하는 representation을 얻을 수 있다. 기존의 방법들과는 다르게 Top level의 LSTM 정보만을 이용하지 않고, 각 level의 hidden state들을 조합해서 새로운 단어 representation을 만들어 낸다.

2. 모델 구조 및 설명

Pre training을 위한 모델의 구조는 Jozefowicz et al.의 CNN-BIG-LSTM 구조를 사용했다고 한다. 이 모델의 구조는, LSTM timestep에 각 단어의 vector representation을 입력할 때, character-level CNN을 이용하며, 2 층의 LSTM Layer를 쓰는 구조이다. 그리고 LSTM과 LSTM의 사이에 projection layer가 들어가 있다.

2-1. Pre-training 단계

모델의 구조는 아래의 그림과 같다.
원본 출처 : http://hugrypiggykim.com/2018/06/08/elmo-deep-contextualized-word-representations/

Input의 형태는 character 기반 CNN으로 embedding한 vector를 사용한다.
구조는 아래 그림과 같다. 사용된 필터의 개수가 word embedding vector의 사이즈가 된다. (Elmo 논문에서 character의 embedding 사이즈를 얼마로 했는지는 찾지 못했다.)

LSTM과 LSTM 있는 projection layer란 개념은 Long Short-Term Memory Recurrent Neural Network Architectures for Large Scale Acoustic Modeling 이란 논문에서 나왔다. Parameter로 쓰이는 matrix의 크기를 줄일 수 있다는 효과가 있는 것 같다.

위의 예시처럼 LSTM의 output인 크기 4096 vector를 projection layer 없이 다음 LSTM의 입력으로 쓴다고 하면 4096*4096의 matrix가 필요하다.
하지만 중간에 512 차원의 projection layer를 넣으면 4096*512 matrix가 2개 필요하고(LSTM =>projection, projection=>LSTM), 결과적으로 4096*1024 만큼의 parameter 수를 갖게 되어 그만큼 크기를 줄일 수 있다.

이렇게 만들어진 projection vector를 output layer로 넘기게 되며, 이 때도 4096*D(output layer size)가 아닌 512*D 만큼의 matrix를 쓰면 되므로, 파라미터의 수를 줄일 수 있다.

학습 방법은 평범한 language modeling과 같다.

Loss function의 윗줄은 forward LSTM을 이용한 language modeling으로, t1 ~ tk-1까지의 단어들로 tk에 올 단어를 예측하기 위한 학습이다. 아랫줄은 backward로 tN에서부터 tk+1까지의 단어들로 tk에 올 단어를 예측하기 위한 학습이다.

위의 Loss function을 이용하여 pre-training을 하고 나면, 실제 task를 수행할 때 Elmo representation을 사용할 준비가 끝난다.

2-2. Elmo의 사용

이제 sentence classification, sentiment analysis 등의 task에 Elmo representation을 사용할 차례다. 사용하는 방법은 아래와 같다.

어떤 Task의 input sentence에 "is"란 단어가 있고, 이 단어에 대한 representation을 얻는다고 생각해보자. Rk의 구성 요소들을 살펴보면, xk은 LSTM의 입력으로 사용된 단어의 representation을 의미하고, h=>1, h<=1, h=>2, h<=2 는 각 LSTM의 projection layer에서 얻어진 forward, backward 방향의 representation을 의미한다.

여기서 Elmo가 context를 반영하는 word representation을 구해낸다는 것을 알 수 있다. Elmo의 구조를 나타내는 첫번째 이미지에 사용된 문장을 예로 들면, "small cat is"란 문장을 입력했을 때 얻어지는 "is"에 대한 projection vector들은 "My contribution is ..."을 입력했을 때 얻어지는 "is"에 대한 projection vector들과 다르다. "is" 전까지 입력된 단어들이 달라 LSTM과 projection layer가 다른 값을 갖기 때문이다. 

이렇게 얻은 ELMo representation은 실제 task를 위한 모델의 입력 벡터에 concatenate 되어 사용된다.

기본적으로 Input word embedding에 concatenate되지만, output vector에도 concatenate하면 좋은 결과를 내는 task도 있다고 한다.

위와 같이 각 단어에 대한 ELMo representation을 얻을 때는 ELMo 모델의 weight들을 고정시킨다.

3. 실험 결과


결과가 좋았다고 한다..........


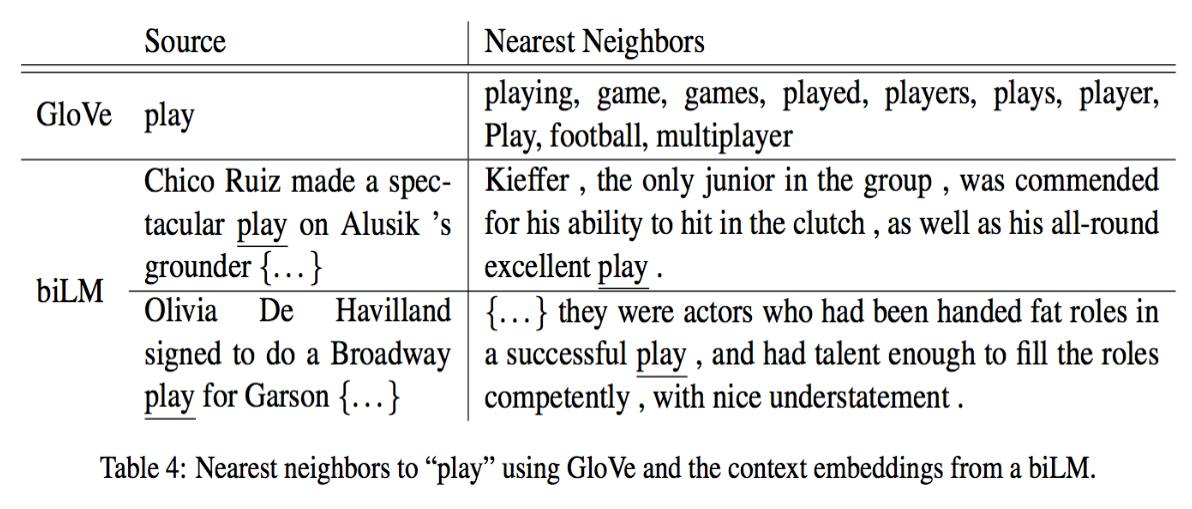
위의 표는 Glove를 통해 얻은 "play"에 대한 벡터와 ELMo를 통해 얻은 "play"에 대한 벡터를 비교한 표이다. Glove는 단어의 representation이 고정되어 있기 때문에 play처럼 여러 뜻을 갖고 있는 단어의 경우 여러 의미를 단어 representation에 담기 어렵다.

하지만 biLM(ELMo)의 경우, LSTM의 이전 step에 입력된 단어에 따라 현재 단어에 해당되는 projection vector들이 변하기 때문에 context에 따라 얻어지는 "play"에 대한 벡터가 다르다. 첫번째 source 문장을 통해 얻어진 "play"의 벡터는 운동 경기에 대한 의미를 나타내어야 하는데, 오른쪽 nearest neighbor를 구해봤을 때 두 "play"의 의미가 비슷하다는 것을 알 수 있다. 반면 두번째 source 문장은 연극에 대한 의미를 반영하는 것을 볼 수 있다.

이 외에도 첫번째 projection layer를 통해 얻어진 벡터들은 주로 syntatic한 의미를 내포하고 있으며, 두번째 layer를 통해 얻어진 벡터들은 좀 더 semantic한 특징을 잡아낸다고 한다.

2018년 12월 11일 화요일

스탠포드 프로젝트 페이지

Stanford의 cs224n : Natural language processing for deep learning 을 듣는 학생들이 한 기말 프로젝트들을 모아 놓은 사이트가 있다.
http://web.stanford.edu/class/cs224n/reports.html

물론 학술대회나 저널에 실린 것보다는 퀄리티가 떨어지겠지만 그래도 좋은 아이디어를 얻을 수 있을 것 같다.

2018년 11월 17일 토요일

20181117 일기

1. 잘 해야겠다.
스포츠 뉴스에서 여자 축구 경기 결과에 대한 뉴스를 보내줬다.
문득, "저 사람들에게 선수들에게 축구는 어떤 의미일까"란 생각이 들었다.
그리고 이어서, 선수들이 축구에 최선을 다하고 있든지, 즐기고 있든지 나는 여자 축구에 별 관심이 없다는 사실이 좀 안타깝게 느껴졌다.
여자 축구를 보면서 이런 생각을 했다는 게 좀 웃길 수 있다.
그동안 내가 너무 즐기는 거에 대해 중점을 뒀던 것 같다는 생각이 들었다.
실제로 재밌기도 하고. 근데 즐기고 있다고 안주하면 안 되겠다고 생각했다.
결론적으로, 잘 해야겠다 라는 생각이 들었다.
(아이유 느낌?ㅋㅋ)

2. 소중한 것
문득 소중하게 느껴지는 것들이 별로 없다는 생각이 들었다.
왜 그럴까 이유를 생각해봤다.
그랬더니, 내가 준 게 별로 없어서 그런가 하는 생각이 들었다.

3. 당연하게 여겨지는 것들
언젠가부터 놀랄 일이 없어졌다는 느낌을 받았다.
누군가가 뭔가를 해서, 열심히 해서, 우연히 겹쳐서, 자연 법칙에 의해서, 결국 무언가가 일어나게 했으니 이런 일이 일어났다는 생각이 굳어졌다.

핑계겠지만 코딩하다 보니 (내가...) 딱 하라고 한 일만 하는 컴터를 봐서 그런 거 같다ㅋㅋㅋ
생각보다 더 잘하는 경우가 없다.
좀 알아서 잘 해주면 감동받을 텐데.
근데 나는 멍청한 컴터에 지능을 심고 있다니

4. 교회에서 보는 행복한 모습
(우리) 같은 교회 사람들이 교회에서 행복하고 즐거운 표정으로 있는 걸 본 기억이 별로 없는 것 같다...
기분 탓인가? 앞으로 좀 유심히 봐야겠다.
와야 되지 않으면 안 오는 곳.

2018년 10월 28일 일요일

Machine Learning, AI Researcher, Engineer 면접 질문, 구직 과정 정리

주요 회사들의 Machine Learning, AI Researcher, Engineer 포지션에 지원하면서 겪게 된 일들을 정리해 보려고 합니다.

0. 참고용으로 쓰는 저의 상태
한양대 컴공 석사 졸
논문 1편, 산학 프로젝트 1개, 개인연구 1개

1. 서류 전형
서류 전형은 이력서를 그렇게 공들여 쓴 게 아님에도 불구하고 다 합격했습니다.

2. 코딩 테스트
보통 Codility를 통해서 봅니다.
Programmers 쓰는 곳도 있긴 합니다.
난이도는 그렇게 어렵지 않았습니다.
특히 Codility 테스트는 삼성전자 코딩 테스트 통과할 정도면 대부분 합격할 것 같고, Programmers에는 어려운 문제가 한 개 정도 있었습니다.
그런데 코딩 테스트에서 모든 문제를 100% 다 맞추지 못해도 합격시켜주는 것 같습니다.
Codility를 통해 한 군데 코딩 테스트를 볼 때 1번 문제가 SQL 문제여서 당황(SQL 잘 못해서... 나중에 공부함 ㅋㅋ) + 오기(웬지 될 거 같은 쓸데 없는 자신감?) 때문에 결국 1번 문제는 풀지도 못하고, 2번문제 풀고, 3번 코딩하다 끝났는데(핵심 로직은 거의 다 쓴 듯) 합격시켜주더라고요.
당연히 떨어진 줄 알았는데...
SQL 문제는 이 때 처음이자 마지막으로 봤습니다.

어떤 데는 추가적으로 논문 구현 코딩 테스트를 요구하기도 합니다.

3. 1차 면접
면접 질문은 보통 4가지 정도로 나눌 수 있을 것 같습니다.
질문 외에 포트폴리오나, 제시하는 논문에 대한 ppt 발표를 시키는 곳도 있습니다.

3-1. 포트폴리오에 대한 질문
어떤 연구를 했는지에 대해 기본적으로 질문합니다.
연구 내용에 대해 당연히 잘 설명해야겠죠.
하지만 중요한 건, 왜 이 문제를 풀기로 했고, 왜 그런 방법을 선택했냐? 라는 질문에 대답을 잘 해야 할 것입니다.
사실 연구가 끝난 시점에서 대학원에서 교수님이 시키는 일을 그냥 했다던지 하면 첫번째 질문에 대해서는 크게 할 말은 없겠지만 그래도 포장?을 잘 해야겠죠.
두번째 질문도 그 당위성을 잘 설명해야할 것입니다.
그래야 앞으로 회사에 들어가서도 올바른 방향으로 연구 개발을 할 것이라 생각을 하겠죠.

3-2. 지식에 대한 질문
확률 통계, 선형대수, 머신 러닝, 딥러닝 모델 등의 개념을 알고 있는지 물어봅니다.
이건 그냥 키워드, 단어 형식으로 정리하겠습니다.
Likelihood란?
Maximum Likelihood estimation과 Maximum A Posteriori estimation의 차이?
Logistic Regression이란?
Linear Regression이란? 푸는 방법 2가지 - 선형대수적 방법, Gradient Descent

SVD란?
SVD의 차원 죽소에 쓰이는 3가지 방법?
Bayesian Rule?
SVM이란?
Conditional Random Field가 뭔지?
Hidden Markov Model?

KL divergence?
Validation set과 Test set을 나누는 이유?
Generative model과 Discriminative model의 차이?
Bayesian Inference?

Dropout?
Normalization 아는 것?
Dilated CNN?
Attention이란?
Memory Network?
Transformer?
Self Attention을 활용한 다른 논문들을 아는지?
인상 깊었던 논문?
최근 읽은 Gan 논문?
Highway network?
Elmo?
World model?


3-3. 문제를 주고 답하게 하는 질문
음... 이건 좀 공개적으로 적기 힘들 것 같습니다^^

3-4. 이력 자체, 인성에 대한 질문
왜 지원했는지? (게임 회사의 경우 왜 게임 회사에 지원했는지를 거의 물어봤던 것 같습니다. + 어떤 게임 좋아하는지, 인공지능을 게임에 어떻게 응용할 수 있을까)
어떤 일을 하고 싶은지?
연구와 개발 어느 쪽에 더 맞는지?
시키는 일을 하고 싶은지, 원하는 일을 찾아서 하는지?
논문 쓰면서 힘들었던 점?
논문 구현은 얼마나 해 봤는지?
왜 Tensorflow를 썼는지(vs PyTorch, Caffe 등)
현재 나와 있는 챗봇, 인공지능 스피커를 쓰고 느낀 점, 개선점?
갈등이 있을 때 어떻게 대처할 것인지?
협업한 경험?
개발 잘 하는지? (질문의 의도가 뭔지.... ㅋㅋㅋ)